Kurz gesagt
Chunking zerlegt Dokumente vor der Indexierung in kleinere Abschnitte, die einzeln eingebettet und gefunden werden. So bleibt jeder Abschnitt unter dem Eingabelimit des Embedding-Modells und passt genauer zu einer Frage. Microsoft empfiehlt als Startwert 512 Token mit 25 Prozent Überlappung. Die beste Größe hängt von Dokumenten und Fragen ab und wird mit Testfragen ermittelt.
Was ist Chunking?
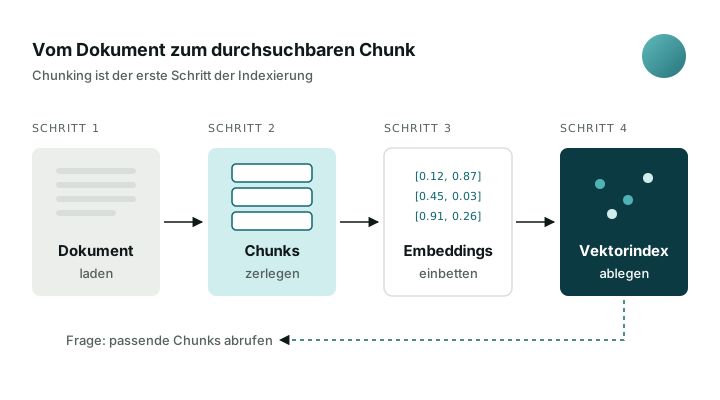
Chunking heißt, lange Dokumente in kleinere Textstücke zu zerlegen, die sogenannten Chunks. Es ist der erste Verarbeitungsschritt in jeder Pipeline für Retrieval Augmented Generation (RAG): Jeder Chunk wird in einen Vektor umgewandelt, im Index abgelegt und bei einer Frage einzeln gesucht.
Schon das Grundlagenpapier zu RAG von Lewis und anderen aus dem Jahr 2020 arbeitet so. Die Autoren zerlegen jeden Wikipedia-Artikel in nicht überlappende Stücke von 100 Wörtern, insgesamt 21 Millionen Dokumente. Für jedes Stück berechnet ein Encoder ein Embedding, das in einem Index für die Vektorsuche landet.
Für eine KI-Wissensdatenbank im Unternehmen gilt dasselbe Prinzip: Das Sprachmodell bekommt bei jeder Frage nur die wenigen Chunks, die dazu passen. Wie gut diese Stücke geschnitten sind, entscheidet mit darüber, ob die richtige Stelle gefunden wird.
Warum zerlegt man Dokumente für RAG?
Der erste Grund ist technisch. Embedding-Modelle verarbeiten nur eine begrenzte Textmenge. Microsoft nennt als Beispiel das Modell text-embedding-3-small mit höchstens 8.191 Token Eingabe; bei rund vier Zeichen je Token entspricht das etwa 6.000 Wörtern. Was darüber hinausgeht, wird abgeschnitten und geht verloren.
Der zweite Grund betrifft die Trefferqualität. Ein einzelner Vektor für ein langes Dokument mischt viele Themen. Microsoft beschreibt das am Beispiel einer Wiki-Seite mit vielen Unterthemen: Sie passt zwar ins Eingabelimit, liefert aber feiner zerlegt oft bessere Ergebnisse. LangChain fasst den Zweck so zusammen: Chunks sollen einzeln auffindbar sein und ins Kontextfenster des Modells passen.
Der dritte Grund liegt beim Sprachmodell selbst. Die Studie „Lost in the Middle“ von Liu und anderen zeigt, dass Modelle Informationen am Anfang oder Ende einer langen Eingabe am besten nutzen und in der Mitte deutlich schlechter. Wenige passende Chunks sind deshalb meist hilfreicher als ganze Dokumente im Kontext.
Welche Chunking-Methoden gibt es?
Die Werkzeuge für RAG bieten mehrere Arten, Text zu zerlegen. Sie unterscheiden sich darin, wo der Schnitt gesetzt wird: nach fester Länge, an Satz- und Absatzgrenzen, an Überschriften oder dort, wo sich die Bedeutung ändert.
LangChain empfiehlt für die meisten Fälle den RecursiveCharacterTextSplitter. Er versucht zuerst, ganze Absätze zu behalten, und geht nur dann auf Sätze und Wörter herunter, wenn ein Stück zu groß ist. LlamaIndex bietet zusätzlich Verfahren, die Chunks in mehreren Größen anlegen oder um jeden Satz ein Fenster aus Nachbarsätzen speichern.
| Methode | Wie geschnitten wird | Passt zu |
|---|---|---|
| Feste Größe | Nach Zeichen oder Token, optional mit Überlappung | Einheitlichem Fließtext, schnellen Prototypen |
| Rekursiv nach Textstruktur | Erst Absätze, dann Sätze, dann Wörter | Den meisten Dokumenten als Standard |
| Nach Dokumentstruktur | An Überschriften in Markdown, Tags in HTML, Funktionen im Code | Handbüchern, Wikis, Quellcode |
| Semantisch | Schnitt dort, wo sich die Ähnlichkeit benachbarter Sätze ändert | Texten mit wechselnden Themen ohne klare Gliederung |
| Hierarchisch | Mehrere Größen, jeder Chunk kennt seinen übergeordneten Abschnitt | Langen Dokumenten mit Detail- und Überblicksfragen |
Welche Chunk-Größe und Überlappung passen?
Eine allgemein richtige Chunk-Größe gibt es nicht, wohl aber belegte Startwerte. Microsoft empfiehlt für Azure AI Search, mit 512 Token zu beginnen, das sind etwa 2.000 Zeichen, und mit einer Überlappung von 25 Prozent, also 128 Token. Als Alternative nennt die Doku feste Abschnitte von etwa 200 Wörtern oder 600 Zeichen mit 10 bis 15 Prozent Überlappung.
Die Überlappung wiederholt das Ende eines Chunks am Anfang des nächsten. So reißt ein Gedanke, der über die Schnittstelle läuft, nicht ab. Laut Microsoft brauchen stark strukturierte Daten weniger Überlappung, erzählende Texte und Gesprächsprotokolle eher mehr.
Größe und Überlappung verändern auch die Menge der Chunks. In Microsofts Beispiel mit einem PDF von 200 Seiten ergeben 1.000 Zeichen ohne Überlappung 172 Chunks, mit 200 Zeichen Überlappung 216 Chunks. Mehr Chunks bedeuten mehr Speicher und mehr Rechenzeit beim Einbetten.
| Quelle | Startwert | Überlappung |
|---|---|---|
| Microsoft Azure AI Search, Token | 512 Token | 128 Token (25 Prozent) |
| Microsoft Text Split, Zeichen | 2.000 Zeichen | 500 Zeichen |
| Microsoft, feste Größe | 200 Wörter oder 600 Zeichen | 10 bis 15 Prozent |
| LlamaIndex SentenceSplitter, Beispiel | 1.024 Token | 20 Token |
Startwerte ersetzen keinen Test. Microsoft rät, die Tokenzahl Ihrer Dokumente vorher zu messen: Sind die Seiten im Schnitt kurz, sind kleinere Chunks sinnvoll, und eine zu große Überlappung kann dazu führen, dass gar keine Überlappung entsteht.
Wie bleibt der Kontext im Chunk erhalten?
Das größte Problem beim Chunking ist verlorener Zusammenhang. Anthropic zeigt das an einem Satz aus einem Quartalsbericht: „Der Umsatz stieg gegenüber dem Vorquartal um 3 Prozent.“ Ohne den Rest des Dokuments fehlen Firmenname und Zeitraum, und der Chunk wird bei einer Frage nach genau diesem Unternehmen kaum gefunden.
Die einfachste Abhilfe nennt Microsoft: den Dokumenttitel an Chunks aus der Mitte des Dokuments anhängen. Dazu kommen Metadaten wie Quelle, Kapitel, Version oder Gültigkeitsdatum, die beim Filtern und bei der Quellenangabe helfen.
Weiter geht das Verfahren Contextual Retrieval, das Anthropic im September 2024 beschrieben hat. Ein Sprachmodell schreibt zu jedem Chunk eine kurze Einordnung aus dem Gesamtdokument, laut Anthropic meist 50 bis 100 Token, und stellt sie vor den Chunk, bevor er eingebettet und für die Stichwortsuche BM25 indexiert wird.
- Kontextuelle Embeddings senkten die Fehlerrate beim Abruf der 20 besten Chunks in Anthropics Tests um 35 Prozent.
- Zusammen mit kontextueller Stichwortsuche sank sie um 49 Prozent, mit zusätzlichem Reranking um 67 Prozent.
Chunking im Unternehmen: Vorgehen in sechs Schritten
Etwa ein Maschinenbauer mit Servicehandbüchern, Wartungsprotokollen und Ersatzteillisten hat drei sehr unterschiedliche Textarten. Eine einzige Einstellung für alles passt selten. Die folgenden Schritte lassen sich auf jede Wissensdatenbank im Unternehmen übertragen.
Dokumente sichten
Ordnen Sie Ihre Unterlagen nach Art: gegliederte Handbücher, Fließtext, Tabellen, Protokolle. Prüfen Sie, ob PDFs echten Text enthalten oder nur Scans.
Länge messen
Zählen Sie Token je Seite oder Dokument, wie Microsoft es mit tiktoken zeigt. Durchschnitt und Maximum zeigen, welche Chunk-Größe überhaupt sinnvoll ist.
Methode je Dokumentart wählen
Gegliederte Texte an Überschriften zerlegen, Fließtext rekursiv nach Absätzen, Tabellen möglichst zusammenhängend lassen.
Startwerte setzen
Beginnen Sie etwa mit 512 Token und 25 Prozent Überlappung und hängen Sie Titel und Kapitel als Metadaten an jeden Chunk.
Mit echten Fragen testen
Sammeln Sie einige Dutzend Fragen aus dem Alltag samt erwarteter Fundstelle und prüfen Sie, ob der richtige Chunk unter den ersten Treffern ist.
Nachjustieren und dokumentieren
Ändern Sie immer nur einen Wert, vergleichen Sie die Trefferquote und halten Sie die gewählte Einstellung je Dokumentart fest.
Typische Fehler beim Chunking
Viele Probleme, die später wie schwache Antworten der KI aussehen, entstehen schon beim Zerlegen. Wer Antworten prüft, sollte deshalb zuerst die gefundenen Chunks ansehen und erst danach am Prompt oder am Modell arbeiten.
Die Wahl der Chunk-Größe hängt eng mit der Vektordatenbank und dem Embedding-Modell zusammen; beide sollten Sie gemeinsam festlegen. Wenn Sie Ihre Dokumentarten und Testfragen schon kennen, können Sie die Wissensdatenbank für Ihr Unternehmen besprechen.
- Tabellen mitten in der Zeile zerschnitten, sodass Werte und Spaltenköpfe getrennt landen.
- Chunks ohne Titel und Quelle, die nach dem Abruf niemand mehr zuordnen kann.
- Eine Einstellung für alle Dokumentarten, obwohl Handbuch und Protokoll anders gebaut sind.
- Gescannte PDFs ohne Texterkennung, die als leere Chunks im Index landen.
- Größe nach Gefühl gewählt und nie mit echten Fragen gegen die erwarteten Fundstellen getestet.
Häufige Fragen
Was bedeutet Chunking bei KI?
Chunking bedeutet, Dokumente in kleinere Abschnitte zu zerlegen, bevor sie in Vektoren umgewandelt und indexiert werden. Bei einer Frage sucht das System die passenden Abschnitte heraus und gibt nur diese an das Sprachmodell weiter.
Wie groß sollte ein Chunk sein?
Als Startwert empfiehlt Microsoft für Azure AI Search 512 Token, etwa 2.000 Zeichen, mit 128 Token Überlappung. Die passende Größe hängt von der Länge Ihrer Dokumente und der Art der Fragen ab und sollte mit echten Testfragen überprüft werden.
Wozu dient die Überlappung zwischen Chunks?
Die Überlappung wiederholt einen kleinen Teil des vorherigen Chunks am Anfang des nächsten. So bleiben Gedanken erhalten, die über eine Schnittstelle laufen. Laut Microsoft brauchen strukturierte Daten weniger, erzählende Texte eher mehr Überlappung.
Was ist semantisches Chunking?
Beim semantischen Chunking setzt das System den Schnitt dort, wo sich die Bedeutung ändert. LlamaIndex vergleicht dafür die Embeddings benachbarter Sätze und trennt an den Stellen mit der geringsten Ähnlichkeit. Eine feste Länge gibt es dabei nicht.
Braucht man Chunking bei kurzen Dokumenten?
Technisch ist Chunking nur nötig, wenn ein Dokument das Eingabelimit des Modells überschreitet. Microsoft weist aber darauf hin, dass auch kurze Seiten mit mehreren Unterthemen feiner zerlegt oft besser gefunden werden.
Quellen
- Chunk Documents (Azure AI Search), Stand 31.08.2026, Microsoft Learn
- Text splitters, LangChain
- Node Parser Modules, LlamaIndex
- Introducing Contextual Retrieval, 19.09.2024, Anthropic
- Lewis u. a.: Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks (2020), arXiv
- Liu u. a.: Lost in the Middle: How Language Models Use Long Contexts (2023), arXiv