Kurz gesagt
Retrieval Augmented Generation (RAG) ist ein Verfahren, bei dem ein KI-System vor jeder Antwort passende Textstellen aus einer Wissensbasis sucht und sie zusammen mit der Frage an das Sprachmodell gibt. Das Modell formuliert die Antwort auf Grundlage dieser Auszüge. So nutzt es Firmenwissen, ohne damit trainiert zu werden, und kann die verwendeten Quellen anzeigen.
Was ist Retrieval Augmented Generation (RAG)?
Retrieval Augmented Generation, kurz RAG, heißt wörtlich „durch Abruf erweiterte Erzeugung“. Ein Sprachmodell beantwortet eine Frage nicht nur aus dem Wissen, das es im Training gelernt hat. Vorher sucht ein Suchsystem passende Abschnitte in einer Dokumentensammlung, und diese Abschnitte landen mit der Frage im Prompt.
Der Begriff stammt aus einem Paper von Patrick Lewis und Kollegen, das 2020 auf der Konferenz NeurIPS angenommen wurde. Die Autoren unterscheiden zwei Arten von Gedächtnis: das parametrische Gedächtnis in den Gewichten eines vortrainierten Modells und ein nicht parametrisches Gedächtnis, im Paper ein dichter Vektorindex der Wikipedia, auf den ein neuronaler Retriever zugreift. Laut den Autoren erzeugte RAG spezifischere und faktentreuere Texte als ein Modell ohne Abruf.
Das BSI beschreibt RAG in seiner Publikation zu generativen KI-Modellen als Maßnahme M14: Das Modell greift auf Dokumente in einer Wissensdatenbank zu, ohne dass diese Inhalte zuvor als Trainingsmaterial verwendet wurden. Genau das macht RAG für Unternehmen interessant. Handbücher, Richtlinien und Verträge bleiben in Ihrer Ablage, und ein Update der Dokumente wirkt bei der nächsten Suche.
RAG ist damit der technische Kern fast jeder KI-Wissensdatenbank: Mitarbeitende stellen Fragen in normaler Sprache und erhalten Antworten mit Verweis auf die Fundstelle.
Wie funktioniert ein RAG-System?
Ein RAG-System arbeitet in zwei Phasen. In der Vorbereitung, der Indexierung, werden Dokumente eingelesen, in Abschnitte zerlegt und durchsuchbar gemacht. Bei jeder Frage folgt die Abfrage: suchen, Prompt zusammenstellen, Antwort erzeugen.
Microsoft beschreibt in der Doku zu Azure AI Search denselben Zuschnitt: Beim Indexieren werden große Dokumente in Abschnitte geteilt, damit Teile einzeln gefunden werden, und ein Vektorisierungsschritt erzeugt Embeddings für die Vektorsuche. Das BSI nennt für Sprachmodelle die semantische Suche über Textembeddings und eine Vektordatenbank als typischen Weg, die relevanten Textstücke vorab zu finden.
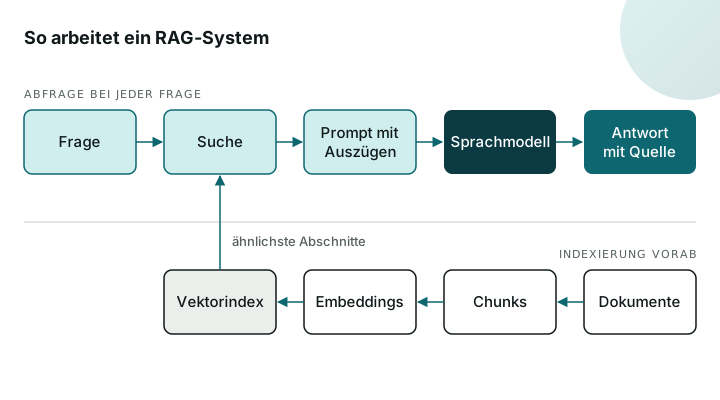
Dokumente zerlegen
Texte aus PDFs, Wikis oder Tickets werden extrahiert und in Abschnitte geteilt, das sogenannte Chunking.
Abschnitte vektorisieren
Ein Embedding-Modell übersetzt jeden Abschnitt in einen Zahlenvektor, der seine Bedeutung abbildet.
Passende Stellen suchen
Die Frage wird ebenso umgewandelt; die Suche liefert die ähnlichsten Abschnitte, oft ergänzt um eine Stichwortsuche.
Prompt anreichern
Frage und gefundene Abschnitte gehen gemeinsam an das Sprachmodell, meist mit der Anweisung, nur diese Auszüge zu nutzen.
Antwort mit Quelle
Das Modell formuliert die Antwort; die Anwendung zeigt an, auf welchen Auszügen sie beruht.
Aus welchen Bausteinen besteht eine RAG-Pipeline?
Eine RAG-Pipeline besteht aus wenigen Bausteinen, die Sie einzeln austauschen können. Die Übersichtsarbeit von Gao und Kollegen (2023) fasst sie in drei Teile: Retrieval, Augmentation und Generation. In der Praxis lohnt ein genauerer Blick, denn jeder Baustein hat eigene Stellschrauben.
Wie Sie Dokumente sinnvoll zerlegen, erklärt die Seite zum Chunking für RAG. Was ein Embedding-Modell leistet und wie Sie eines auswählen, steht bei den Embeddings. Wo die Vektoren liegen und wie die Suche technisch läuft, zeigt die Seite zur Vektordatenbank.
| Baustein | Aufgabe | Typische Frage |
|---|---|---|
| Konnektoren und Parser | Inhalte aus Dateiablage, Wiki oder Ticketsystem lesen | Welche Quellen sind aktuell und verbindlich? |
| Chunking | Dokumente in suchbare Abschnitte teilen | Wie groß sind die Abschnitte, bleiben Tabellen ganz? |
| Embedding-Modell | Texte in Vektoren übersetzen | Versteht das Modell deutsche Fachbegriffe? |
| Index | Vektoren und Metadaten speichern, Suche ausführen | Reicht Vektorsuche, oder braucht es Stichworte dazu? |
| Reranking | Treffer nach Relevanz neu ordnen | Landet die beste Stelle wirklich oben? |
| Sprachmodell | Antwort aus Frage und Auszügen formulieren | Hält sich das Modell an die Auszüge? |
Naive, Advanced und Modular RAG: was die Varianten unterscheidet
Gao und Kollegen ordnen die Entwicklung in drei Stufen. Naive RAG ist die einfache Kette aus Indexieren, Suchen und Erzeugen. Advanced RAG verbessert die Schritte vor und nach der Suche, etwa durch umformulierte Anfragen oder eine neue Sortierung der Treffer. Modular RAG setzt die Bausteine flexibel zusammen, etwa mit mehreren Suchen hintereinander.
Zwei Verbesserungen tauchen in fast jeder Doku auf. Die erste ist die hybride Suche: Microsoft empfiehlt für RAG hybride Abfragen aus Stichwort- und Vektorsuche, um möglichst viele relevante Stellen zu finden, und eine semantische Neubewertung der Treffer. Die zweite ist das Reranking: Ein zweites Modell ordnet eine größere Trefferliste nach Relevanz, und nur die besten Abschnitte gehen an das Sprachmodell.
Wie viel solche Schritte bringen können, zeigt ein Bericht von Anthropic zu „Contextual Retrieval“. Dabei bekommt jeder Abschnitt vor der Vektorisierung einen kurzen erklärenden Kontext. In den Tests sank der Anteil fehlgeschlagener Suchen unter den Top 20 Treffern mit kontextualisierten Embeddings um 35 Prozent, zusammen mit einer kontextualisierten Stichwortsuche (BM25) um 49 Prozent und mit zusätzlichem Reranking um 67 Prozent. Das sind Messwerte des Anbieters auf seinen Testdaten; prüfen Sie Verbesserungen immer mit eigenen Fragen.
RAG, Fine-Tuning oder alles in den Prompt?
RAG ist nicht der einzige Weg, ein Sprachmodell mit Firmenwissen zu verbinden. Beim Fine-Tuning wird das Modell mit eigenen Beispielen weitertrainiert; es lernt eher Stil, Format und Fachsprache, und neue Fakten erfordern ein neues Training. Wann sich das lohnt, erklärt die Seite zum Fine-Tuning im Vergleich zu RAG.
Bei kleinen Wissensbeständen geht es noch einfacher. Anthropic schreibt, dass man eine Wissensbasis unter 200.000 Token, etwa 500 Seiten, auch vollständig in den Prompt geben kann. Allerdings zeigt die Studie „Lost in the Middle“ von Liu und Kollegen (2023), dass Sprachmodelle Informationen am Anfang und Ende langer Eingaben am besten nutzen und in der Mitte schlechter.
Hängen Antworten an Beziehungen zwischen Dingen, etwa welches Bauteil in welcher Maschine steckt und welcher Lieferant es liefert, reicht reine Textsuche oft nicht. Dann kann ein Knowledge Graph als Ergänzung zu RAG helfen.
| Ansatz | Passt, wenn | Aufwand bei neuen Inhalten |
|---|---|---|
| RAG | viele Dokumente sich laufend ändern und Quellen sichtbar sein sollen | Dokument neu indexieren |
| Fine-Tuning | das Modell Stil, Format oder Fachsprache lernen soll | Neues Training |
| Ganzer Bestand im Prompt | der Bestand klein ist und selten wechselt | Prompt austauschen |
| RAG mit Wissensgraph | Beziehungen zwischen Objekten die Antwort tragen | Dokumente und Graph pflegen |
Wo stößt RAG an Grenzen?
RAG ist nur so gut wie seine Suche. Findet das System die richtige Stelle nicht, antwortet das Modell aus seinem allgemeinen Wissen oder gar nicht. Microsoft nennt als typische Hürden Fragen, deren Wortwahl nicht zur Wortwahl der Dokumente passt, Inhalte verstreut über viele Systeme und die begrenzte Länge der Eingabe.
Auch eine gefundene Stelle garantiert keine richtige Antwort. Das BSI schreibt, dass sich die Auswirkungen von Halluzinationen mildern lassen, weil Nutzende sehen können, auf welchen Textauszügen die Antwort beruht. Von Verhindern ist dort keine Rede. Warum Sprachmodelle trotzdem Falsches behaupten, erklärt die Seite zu KI-Halluzinationen auf kiagentensicherheit.de.
Die dritte Grenze ist der Bestand selbst. Veraltete Versionen, doppelte Dateien und widersprüchliche Richtlinien findet die Suche genauso zuverlässig wie die aktuellen. Ohne Pflege der Quellen liefert auch das beste RAG-System falsche Antworten mit echter Fundstelle.
Liegt das Wissen auf viele Systeme verteilt, braucht die Suche Anschluss an jedes davon und muss dort die Rechte beachten. Wie eine solche Unternehmenssuche aufgebaut ist, zeigt die Seite zur Enterprise Search.
- Suchfehler: Die passende Stelle fehlt in den Treffern, weil Begriffe anders lauten.
- Schnittfehler: Ein Abschnitt reißt Tabelle oder Ablauf auseinander, Kontext geht verloren.
- Bestandsfehler: Alte oder widersprüchliche Dokumente stehen gleichrangig im Index.
- Modellfehler: Das Modell ergänzt Details, die in keinem Auszug stehen.
Zugriffsrechte, Sicherheit und Datenschutz im RAG-System
Ein RAG-System darf niemandem Inhalte zeigen, die er in der Ablage nicht öffnen dürfte. Das BSI empfiehlt, Informationen bei der Suche über ein Rechte- und Rollenkonzept nur bestimmten Nutzergruppen bereitzustellen, und rät ausdrücklich davon ab, dieses Konzept über textuelle Anweisungen an das Modell umzusetzen, weil das angreifbar ist. Die Rechte gehören also in die Suche. Microsoft nennt dafür das Kürzen der Treffer auf Dokumentebene anhand übernommener Berechtigungen.
Das BSI beschreibt außerdem zwei Angriffe, die erst durch RAG entstehen. Bei der Vergiftung von Wissensdaten schleusen Angreifende manipulierte Inhalte in die Wissensbasis, die das Modell bei bestimmten Fragen zu vorgegebenen Ausgaben verleiten. Bei der Extraktion zielen Angriffe auf Informationen aus Dokumenten, die per RAG in den Prompt kopiert werden. Wie versteckte Anweisungen in Dokumenten wirken, erklärt die Seite zu Prompt Injection auf kiagentensicherheit.de.
Enthalten die Dokumente personenbezogene Daten, gilt die DSGVO auch für den Index. Verlangt eine Person nach Art. 17 DSGVO die Löschung ihrer Daten, reicht es nicht, die Originaldatei zu entfernen: Auch die Abschnitte und Vektoren im Index müssen verschwinden. Planen Sie deshalb von Anfang an, wie Löschungen aus der Quelle im Index ankommen.
Diese Seite erklärt technische und rechtliche Zusammenhänge allgemein und ersetzt keine Rechtsberatung. Klären Sie die Verarbeitung personenbezogener Daten in einem RAG-System mit Ihrer Datenschutzbeauftragten oder Ihrem Datenschutzbeauftragten.
Wie messen Sie die Qualität eines RAG-Systems?
Ein RAG-System lässt sich nicht nach Gefühl beurteilen. Das Bewertungsverfahren Ragas von Es und Kollegen (2023) prüft getrennt, ob die Suche relevante und fokussierte Abschnitte findet, ob das Modell diese Abschnitte treu verwendet und wie gut die erzeugte Antwort ist. Ragas kommt dabei ohne von Menschen erstellte Musterantworten aus.
Für den Start im Unternehmen reicht ein einfacher Testsatz. Sammeln Sie echte Fragen aus Support, Vertrieb oder Fachabteilung und notieren Sie, in welchem Dokument die richtige Antwort steht. Damit prüfen Sie jede Änderung an Chunking, Modell oder Suche gegen denselben Maßstab.
- Trefferquote: Steht die richtige Fundstelle unter den ersten Treffern?
- Quellentreue: Steht jede Aussage der Antwort auch im zitierten Auszug?
- Ehrlichkeit: Sagt das System „nicht gefunden“, wenn der Bestand keine Antwort hat?
- Rechte: Bekommt ein Testkonto ohne Freigabe wirklich keine gesperrten Inhalte?
RAG im Unternehmen einführen: Schritt für Schritt
Halten Sie den ersten Umfang klein. Beginnen Sie mit einem Bereich, in dem viele wiederkehrende Fragen auf gut gepflegte Dokumente treffen, etwa ein Maschinenbauer mit Servicehandbüchern oder eine Personalabteilung mit Richtlinien.
Wer Dokumente nicht an einen Cloud-Dienst geben möchte, kann Embedding-Modell, Index und Sprachmodell auch selbst betreiben; was dafür nötig ist, zeigt die Seite zur lokalen KI auf eigener Hardware. Möchten Sie den Zuschnitt für Ihre Dokumente klären, können Sie die Wissensdatenbank für Ihr Unternehmen besprechen.
Anwendungsfall eingrenzen
Wählen Sie eine Nutzergruppe und 20 bis 50 echte Fragen, die das System beantworten soll.
Quellen bereinigen
Legen Sie fest, welche Dokumente verbindlich sind, und entfernen Sie Entwürfe, Dubletten und alte Versionen.
Rechte abbilden
Übernehmen Sie die Berechtigungen der Quellsysteme in den Index, bevor Sie echte Daten laden.
Pipeline aufbauen und messen
Starten Sie mit Standardwerten für Chunking und Suche und messen Sie gegen Ihren Testsatz.
Verbessern und betreiben
Ergänzen Sie hybride Suche oder Reranking nur, wenn die Messung zeigt, dass sie helfen, und planen Sie die Aktualisierung des Index.
Häufige Fragen
Was bedeutet RAG bei KI?
RAG steht für Retrieval Augmented Generation. Ein KI-System sucht vor der Antwort passende Abschnitte in einer Dokumentensammlung und gibt sie dem Sprachmodell mit. Die Antwort beruht dann auf diesen Auszügen und weniger auf dem allgemeinen Trainingswissen des Modells.
Was ist ein RAG-Chatbot?
Ein RAG-Chatbot ist ein Chat, der hinter jeder Frage eine Suche in festgelegten Dokumenten ausführt. Im Unternehmen sind das etwa Handbücher, Richtlinien oder Produktdaten. Gute RAG-Chatbots zeigen zu jeder Antwort die Fundstelle, damit Nutzende sie prüfen können.
Lernt das Sprachmodell durch RAG dazu?
Nein. Die Gewichte des Modells bleiben unverändert. Das BSI beschreibt RAG als Zugriff auf Dokumente, die nicht als Trainingsmaterial verwendet wurden. Das Wissen steckt im Index, und eine Änderung am Dokument wirkt, sobald es neu indexiert ist.
Braucht RAG immer eine Vektordatenbank?
Nicht zwingend. Häufig ist es eine Vektorsuche, aber auch eine klassische Stichwortsuche wie BM25 kann Abschnitte liefern. Microsoft empfiehlt für RAG hybride Abfragen, die beides kombinieren.
Verhindert RAG Halluzinationen?
RAG mindert sie. Das Modell kann trotzdem Auszüge falsch zusammenfassen oder Details ergänzen. Das BSI betont, dass angezeigte Quellen die Auswirkungen mildern, weil Nutzende die Antwort am Auszug prüfen können.
Ab welcher Datenmenge lohnt sich RAG?
Eine feste Grenze gibt es nicht. Anthropic nennt als Faustwert, dass eine Wissensbasis unter 200.000 Token, etwa 500 Seiten, auch komplett in den Prompt passen kann. Bei größeren oder oft wechselnden Beständen und bei unterschiedlichen Zugriffsrechten spricht mehr für RAG.
Was ist eine RAG-Pipeline?
Mit RAG-Pipeline ist die Kette aller Verarbeitungsschritte gemeint: Dokumente einlesen, zerlegen, vektorisieren, speichern, suchen, Treffer sortieren und die Antwort erzeugen. Jeder Schritt lässt sich einzeln messen und austauschen.
Quellen
- Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks (Lewis et al., NeurIPS 2020), arXiv
- Retrieval-Augmented Generation for Large Language Models: A Survey (Gao et al., 2023), arXiv
- Generative KI-Modelle: Chancen und Risiken für Industrie und Behörden, Risiko R18 und Maßnahme M14, BSI
- RAG and Generative AI: Azure AI Search, Microsoft Learn
- Introducing Contextual Retrieval, Anthropic
- Lost in the Middle: How Language Models Use Long Contexts (Liu et al., 2023), arXiv
- Ragas: Automated Evaluation of Retrieval Augmented Generation (Es et al., 2023), arXiv
- Art. 17 DSGVO: Recht auf Löschung, dsgvo-gesetz.de