Kurz gesagt
Fine-Tuning passt ein vortrainiertes Modell durch zusätzliches Training an eine Aufgabe an. Es eignet sich für Stil, Format, Klassifikation und Werkzeugnutzung. Für Firmenwissen, das sich ändert und belegt werden soll, ist RAG meist die bessere Wahl: Eine Studie fand RAG beim Einbringen von Wissen durchgehend vorn, und Microsoft betont, dass Fine-Tuning den Abruf aktueller Informationen nicht ersetzt.
Was ist Fine-Tuning?
Fine-Tuning passt ein vortrainiertes Modell durch zusätzliches Training mit aufgabenbezogenen Daten an. Microsoft beschreibt es so: Das Verfahren verändert die Gewichte des Modells, statt jedem Prompt Beispiele mitzugeben, und baut auf den vorhandenen Fähigkeiten auf, ohne ein Modell von Grund auf zu trainieren.
Microsoft Foundry nennt drei Methoden. Beim überwachten Fine-Tuning (SFT) lernt das Modell aus Paaren von Eingabe und gewünschter Antwort. Beim Präferenz-Fine-Tuning (DPO) lernt es aus einer bevorzugten und einer abgelehnten Antwort auf dieselbe Eingabe. Beim Reinforcement Fine-Tuning (RFT) bewertet ein Prüfverfahren die erzeugten Antworten.
Google unterscheidet außerdem nach dem Umfang. Volles Fine-Tuning verändert alle Parameter, ist laut Google aber in Training und Betrieb teurer. Parametereffizientes Tuning verändert nur einen kleinen Teil. Das bekannteste Verfahren ist LoRA: Es friert die ursprünglichen Gewichte ein und trainiert kleine Zusatzmatrizen. Beim Fine-Tuning von GPT-3 175B sank die Zahl trainierbarer Parameter laut Paper um das 10.000-Fache und der Bedarf an GPU-Speicher um das Dreifache.
Fine-Tuning oder RAG: Was ist der Unterschied?
Beide Ansätze bringen ein Modell näher an das eigene Unternehmen, aber an verschiedenen Stellen. Fine-Tuning schreibt Muster in die Gewichte des Modells. Retrieval Augmented Generation (RAG) lässt das Modell unverändert und gibt ihm bei jeder Frage passende Textstellen aus einer Vektordatenbank mit.
Das Grundlagenpapier zu RAG von Lewis und anderen nennt zwei offene Probleme von Modellen, die Wissen nur in ihren Parametern speichern: Sie können schwer belegen, woher eine Aussage stammt, und ihr Weltwissen lässt sich schwer aktualisieren. Ein externer Speicher, den ein Suchschritt abfragt, setzt genau dort an.
| Merkmal | Fine-Tuning | RAG |
|---|---|---|
| Wo das Wissen liegt | In den Gewichten des Modells | In Dokumenten und Index außerhalb des Modells |
| Neues Dokument aufnehmen | Neues Training und neue Bereitstellung | Dokument indexieren |
| Quelle zur Antwort | Nicht direkt ablesbar | Gefundene Textstelle lässt sich anzeigen |
| Benötigte Daten | Beispiele aus Eingabe und Antwort | Vorhandene Dokumente |
| Stärke | Stil, Format, Klassifikation, Werkzeugnutzung | Faktenwissen, das sich ändert |
Lernt ein Modell durch Fine-Tuning Ihr Firmenwissen?
Nur eingeschränkt. Ovadia und andere haben 2023 verglichen, wie gut sich Wissen per Fine-Tuning und per RAG in Sprachmodelle einbringen lässt. Ergebnis: RAG war durchgehend besser, sowohl bei Wissen, das das Modell schon im Training gesehen hatte, als auch bei völlig neuem Wissen.
Die Autoren stellen fest, dass Sprachmodelle neue Fakten durch unüberwachtes Fine-Tuning nur schwer lernen. Es half etwas, dieselbe Tatsache in vielen Varianten zu zeigen. Für ein Unternehmen mit umfangreichen Handbüchern lässt das hohen Aufwand bei unsicherem Ergebnis erwarten.
Microsoft schreibt in der Doku zu Foundry ausdrücklich, dass Fine-Tuning den Abruf aktueller Informationen nicht ersetzt. Für eine KI-Wissensdatenbank, deren Inhalte sich ändern und deren Antworten belegbar sein sollen, ist RAG deshalb der übliche Kern.
Auch mit RAG kann ein Modell falsche Aussagen erzeugen. Wie Sie solche Fehler erkennen und begrenzen, steht auf der Seite zu KI-Halluzinationen.
Wann ist Fine-Tuning die richtige Wahl?
Fine-Tuning spielt seine Stärken aus, wenn es um das Verhalten des Modells geht. Liegen hochwertige Trainingsdaten vor, nennt Microsoft diese Einsatzfälle: Genauigkeit bei einer bestimmten Aufgabe, kürzere Prompts, gleichbleibender Stil und Aufbau, bessere Werkzeugnutzung und ein kleineres Modell, das eine Aufgabe günstiger erledigt.
Google empfiehlt überwachtes Fine-Tuning für Aufgaben, deren Ergebnis nicht komplex und gut zu beschreiben ist, etwa Klassifikation, Stimmungsanalyse und das Herausziehen von Entitäten. OpenAI nennt für SFT unter anderem Klassifikation, bestimmte Ausgabeformate und das Beheben von Fehlern beim Befolgen von Anweisungen.
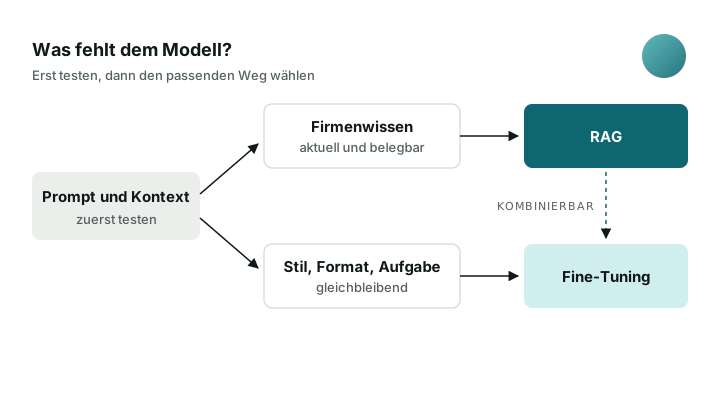
Beide Wege lassen sich verbinden. Microsoft führt ausdrücklich auf, dass ein Modell per Fine-Tuning lernen kann, abgerufenen Kontext besser zu nutzen und Unpassendes zu übergehen. Das Wissen kommt dann weiter aus RAG, das Fine-Tuning verbessert den Umgang damit.
- Etwa ein Versicherer, der Schadensmeldungen automatisch einer von zwanzig Kategorien zuordnen will.
- Etwa ein Händler, der Produkttexte in einem festen Format mit gleichbleibender Tonalität braucht.
- Etwa ein Servicebereich, der ein kleineres Modell für eine eng umrissene Aufgabe betreiben will.
Eigene KI trainieren: Was heißt das wirklich?
Wer „eine eigene KI trainieren“ möchte, meint selten das Training eines Sprachmodells von Grund auf. Fast immer geht es darum, ein vorhandenes Modell mit eigenem Wissen oder eigenem Stil arbeiten zu lassen. Dafür gibt es vier Stufen mit steigendem Aufwand.
Die Hersteller raten übereinstimmend, unten anzufangen. Google empfiehlt, zuerst den besten Prompt zu finden und erst bei Bedarf zum Fine-Tuning überzugehen. OpenAI schreibt, Prompt Engineering könne bereits alles sein, was ein Anwendungsfall braucht, und rät, Tests zur Bewertung schon vor dem ersten Prompt zu schreiben.
| Stufe | Was passiert | Typischer Zweck |
|---|---|---|
| Prompt und Kontext | Anweisungen und Beispiele im Prompt, Modell bleibt unverändert | Erste Tests, einfache Aufgaben |
| RAG | Passende Dokumente werden bei jeder Frage mitgegeben | Firmenwissen mit Quellenangabe |
| Fine-Tuning | Gewichte werden mit eigenen Beispielen angepasst, oft parametereffizient | Stil, Format, Klassifikation |
| Training von Grund auf | Ein neues Modell lernt aus einer sehr großen Textmenge | Forschung und Modellanbieter |
Was braucht ein Fine-Tuning-Projekt?
Zuerst Daten. Google nennt als Richtwert einen Datensatz von 100 Beispielen oder mehr und für überwachtes Fine-Tuning Hunderte bis Tausende beschriftete Beispiele. Wichtiger als die Menge ist laut Google die Qualität. Microsoft rät, Trainings-, Validierungs- und Testdaten zu trennen und das Ergebnis an zurückgehaltenen Aufgaben mit dem Ausgangsmodell zu vergleichen.
Dann Budget und Pflege. Laut Microsoft kommen Kosten für Training und Betrieb hinzu, Experimente brauchen oft mehrere Durchläufe, und wenn sich Daten ändern oder ein Basismodell ausläuft, kann ein neues Training nötig werden. Auch Anbieter ändern ihr Angebot: OpenAI fährt seine Fine-Tuning-Plattform laut eigener Doku zurück und nimmt keine neuen Nutzer mehr auf (Stand laut Anbieter, November 2026).
Schließlich der Ort. Bei Microsoft Foundry sichert laut Doku der Trainingstyp Standard die Datenresidenz in der Region zu, den Typ Data Zone gibt es derzeit nur für die USA. Beim Typ Global werden Daten und Gewichte in die Region kopiert, in der trainiert wird. Für personenbezogene Trainingsdaten sind damit die Regeln für Übermittlungen in Drittländer zu prüfen, etwa ein Angemessenheitsbeschluss oder geeignete Garantien nach Art. 46 DSGVO. Wer Modelle auf eigener Hardware betreiben will, findet Hinweise unter lokale KI.
Fine-Tuning oder RAG: Entscheidung in fünf Schritten
Die folgenden Schritte helfen, die Frage für einen konkreten Anwendungsfall zu klären. Sie setzen voraus, dass Sie typische Fragen und erwartete Antworten sammeln können.
Ziel benennen
Halten Sie fest, ob das Modell Fakten aus Ihren Dokumenten liefern oder eine Aufgabe in bestimmter Form erledigen soll.
Testfälle schreiben
Sammeln Sie echte Fragen mit erwarteter Antwort. Ohne diese Tests lässt sich keine der Stufen fair bewerten.
Mit Prompt und Kontext beginnen
Prüfen Sie, wie weit gute Anweisungen und Beispiele im Prompt schon kommen.
Wissen per RAG anbinden
Fehlt Firmenwissen, binden Sie die Dokumente über Chunking und Vektorsuche an und messen erneut.
Fine-Tuning gezielt prüfen
Bleiben Fehler bei Stil, Format oder Aufgabe, testen Sie Fine-Tuning mit sauberen Beispielen gegen dieselben Testfälle.
Was kostet der Weg zu eigenem Firmenwissen in der KI?
Die Kosten hängen unter anderem an Datenmenge, Betriebsort und Pflegeaufwand. Eine Übersicht der Kostenfaktoren steht unter Kosten einer KI-Wissensdatenbank.
Wenn Sie Ihre Testfälle beisammen haben und unsicher sind, ob RAG reicht, können Sie die Wissensdatenbank für Ihr Unternehmen besprechen.
Häufige Fragen
Was ist LLM Fine-Tuning?
LLM Fine-Tuning ist das zusätzliche Training eines vortrainierten großen Sprachmodells mit eigenen Beispielen. Dabei verändern sich die Gewichte des Modells, sodass es eine Aufgabe, einen Stil oder ein Format besser beherrscht.
Ist RAG besser als Fine-Tuning?
Für Faktenwissen meist ja. In der Studie von Ovadia und anderen war RAG beim Einbringen von Wissen durchgehend besser als unüberwachtes Fine-Tuning. Für Stil, Format und eng umrissene Aufgaben kann Fine-Tuning die bessere Ergänzung sein.
Kann ich eine eigene KI mit Firmendaten trainieren?
Ein eigenes Sprachmodell von Grund auf zu trainieren, ist für Unternehmen selten sinnvoll. Üblich ist, ein vorhandenes Modell per RAG mit Ihren Dokumenten zu verbinden und es bei Bedarf per Fine-Tuning auf Stil oder Aufgabe anzupassen.
Wie viele Daten braucht Fine-Tuning?
Google nennt für Vertex AI als Richtwert 100 Beispiele oder mehr und für überwachtes Fine-Tuning Hunderte bis Tausende beschriftete Beispiele. Die Qualität der Beispiele ist laut Google wichtiger als ihre Zahl.
Was ist LoRA?
LoRA (Low-Rank Adaptation) ist ein parametereffizientes Verfahren für Fine-Tuning. Es lässt die Gewichte des Modells unverändert und trainiert kleine Zusatzmatrizen. Das senkt die Zahl trainierbarer Parameter und den Speicherbedarf deutlich.
Quellen
- Fine-tuning in Microsoft Foundry, Stand 29.10.2026, Microsoft Learn
- Model optimization, OpenAI
- Tune Gemini models (Vertex AI), Google Cloud
- Ovadia u. a.: Fine-Tuning or Retrieval? Comparing Knowledge Injection in LLMs (2023), arXiv
- Hu u. a.: LoRA: Low-Rank Adaptation of Large Language Models (2021), arXiv
- Lewis u. a.: Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks (2020), arXiv
- Internationale Datenübermittlung: Datenübermittlungen in die USA und Schrems-II-Urteil, BfDI