Kurz gesagt
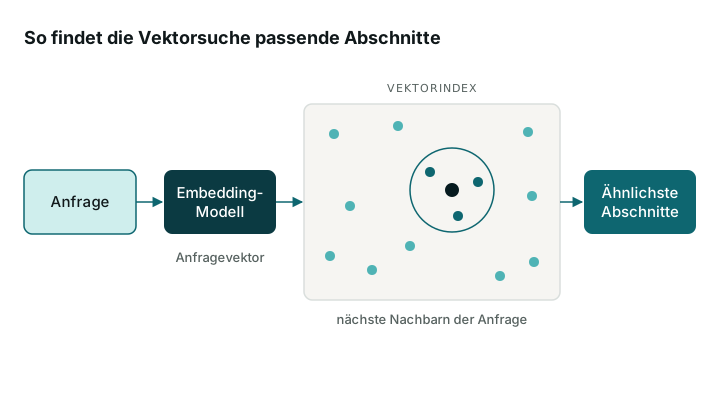
Eine Vektordatenbank ist ein Speicher, der Inhalte als Vektoren ablegt und nach Ähnlichkeit durchsucht. Eine Anfrage wird mit demselben Embedding-Modell in einen Vektor übersetzt; die Datenbank liefert die Einträge mit dem geringsten Abstand. So findet eine semantische Suche passende Stellen auch dann, wenn andere Wörter verwendet werden als in der Frage.
Was ist eine Vektordatenbank?
Eine Vektordatenbank speichert Inhalte als Listen von Zahlen, sogenannte Vektoren. Diese Vektoren erzeugt ein Embedding-Modell, das ähnliche Inhalte auf nahe beieinander liegende Punkte abbildet. Die Datenbank beantwortet dann vor allem eine Frage: Welche gespeicherten Vektoren liegen dem Vektor der Anfrage am nächsten?
Milvus beschreibt sich in seiner Doku als Vektordatenbank, die Embeddings zusammen mit strukturierten Metadaten speichert und durchsucht. Qdrant gliedert die Daten in Collections, also benannte Mengen von Points; jeder Point hat einen Vektor und optional eine Payload mit Metadaten wie Abteilung, Datum oder Dokumenttyp.
In einem RAG-System ist die Vektordatenbank der Index, in dem die zerlegten Abschnitte Ihrer Dokumente liegen. Bei jeder Frage holt sie die passenden Abschnitte, die das Sprachmodell für seine Antwort nutzt. Für eine KI-Wissensdatenbank ist sie damit das Suchgedächtnis.
Wie funktioniert Vektorsuche?
Microsoft erklärt Vektorsuche als Suche über numerische Darstellungen von Inhalten, bei der die Vektoren gefunden werden, die dem Anfragevektor am ähnlichsten sind. Damit findet die Suche Treffer über Bedeutung: „dog“ und „canine“ sind sprachlich verschieden, aber inhaltlich ähnlich, und auch das englische „dog“ und das deutsche „Hund“ liegen nah beieinander, wenn das Modell mehrsprachig ist.
Wie „nah“ zwei Vektoren sind, misst ein Abstandsmaß. pgvector, die Vektorerweiterung für PostgreSQL, bietet dafür eigene Operatoren an. Welches Maß passt, hängt vom Embedding-Modell ab: OpenAI empfiehlt für seine Embeddings die Kosinus-Ähnlichkeit, und Ollama nennt sie für die meisten Fälle semantischer Suche die empfohlene Wahl.
| Abstandsmaß | Operator in pgvector | Was es misst |
|---|---|---|
| Euklidischer Abstand (L2) | <-> | Gerade Strecke zwischen zwei Punkten |
| Negatives Skalarprodukt | <#> | Skalarprodukt mit umgekehrtem Vorzeichen, kleiner heißt ähnlicher |
| Kosinus-Abstand | <=> | Winkel zwischen den Vektoren, unabhängig von ihrer Länge |
Exakte oder approximative Suche: was HNSW leistet
Die einfachste Suche vergleicht die Anfrage mit jedem gespeicherten Vektor. pgvector arbeitet ohne Index genau so und schreibt, dass diese exakte Suche eine vollständige Trefferquote liefert. Bei vielen Millionen Vektoren wird das langsam.
Deshalb nutzen Vektordatenbanken approximative Verfahren, die sehr schnell sehr gute Treffer finden, aber nicht garantiert die besten. Das verbreitete Verfahren HNSW stammt von Malkov und Yashunin (2016): Es baut einen mehrschichtigen Graphen, in dem die oberen Schichten wenige weit verbundene Punkte enthalten. Die Suche beginnt oben und arbeitet sich nach unten vor; die Autoren beschreiben dafür ein logarithmisches Wachstum des Aufwands.
pgvector bietet neben HNSW auch IVFFlat an. Laut Doku hat HNSW das bessere Verhältnis von Geschwindigkeit und Trefferquote, baut sich aber langsamer auf und braucht mehr Speicher. IVFFlat baut schneller und braucht weniger Speicher, sollte aber erst angelegt werden, wenn Daten in der Tabelle stehen. Wichtig für die Praxis: Mit einem approximativen Index können sich Suchergebnisse ändern, weil etwas Trefferquote gegen Geschwindigkeit getauscht wird.
Semantische Suche und hybride Suche
Semantische Suche heißt, nach Bedeutung zu suchen. Für Unternehmensdokumente reicht sie allein oft nicht. Artikelnummern, Normbezeichnungen oder Produktnamen trifft eine klassische Stichwortsuche zuverlässiger, weil es dort auf die exakte Zeichenfolge ankommt.
Die Lösung ist die hybride Suche. Weaviate führt dafür Vektorsuche und die Stichwortsuche BM25 parallel aus und verschmilzt die Ergebnisse zu einer Rangliste. Ein Parameter namens alpha gewichtet die beiden Teile: 0 bedeutet nur Stichworte, 1 nur Vektoren, der Standardwert auf dem Server ist laut Doku 0,75. Microsoft beschreibt hybride Suche in Azure AI Search ebenso als Vektor- und Stichwortsuche in einer Anfrage und schreibt, dass sie oft bessere Ergebnisse liefert als jede der beiden allein.
Auch pgvector lässt sich mit der Volltextsuche von PostgreSQL kombinieren; die Doku verweist zum Zusammenführen der Ergebnislisten auf Reciprocal Rank Fusion oder ein Cross-Encoder-Modell. Wie Sie die Abschnitte zuschneiden, die in diesen Index wandern, beeinflusst beide Suchwege; mehr dazu auf der Seite zum Chunking von Dokumenten.
Filter, Metadaten und Zugriffsrechte
Ähnlichkeit allein reicht im Unternehmen selten. Oft soll die Suche nur gültige Dokumente, nur einen Standort oder nur Inhalte durchsuchen, die die fragende Person sehen darf. Dafür speichern Vektordatenbanken Metadaten neben dem Vektor und filtern danach.
Qdrant kombiniert Filterbedingungen mit den Klauseln must, should und must_not, also UND, ODER und NICHT, und empfiehlt Indexe auf Feldern, nach denen gefiltert wird, möglichst vor dem Laden der Daten. pgvector weist auf eine Falle hin: Bei approximativen Indexen wird erst nach dem Indexdurchlauf gefiltert, sodass ein strenger Filter weniger Treffer liefern kann als erwartet. Die Doku nennt dafür Gegenmittel wie partielle Indexe, Partitionierung oder iterative Indexscans.
Für Zugriffsrechte ist dieser Mechanismus entscheidend. Das BSI rät in seiner Publikation zu generativen KI-Modellen, Inhalte in einem RAG-System über ein Rechte- und Rollenkonzept bei der Suche zu selektieren, und rät davon ab, das über Textanweisungen an das Modell zu lösen. Legen Sie Berechtigungen deshalb als filterbare Metadaten an jedem Abschnitt ab.
Welche Vektordatenbank passt zu Ihrem Unternehmen?
Die Auswahl hängt weniger von Bestenlisten ab als davon, was Sie schon betreiben. Wer PostgreSQL im Haus hat, kann mit pgvector beginnen und Vektoren neben den übrigen Daten speichern. Wer eine eigene Suchplattform will, findet spezialisierte Systeme mit eigenem Betrieb oder als verwalteten Dienst.
Die Tabelle nennt Beispiele mit Eigenschaften aus der jeweiligen Doku, Stand laut Anbieter, November 2026. Sie ist keine Rangliste. Leistungsangaben der Hersteller beruhen auf eigenen Tests; prüfen Sie sie mit Ihren Daten. Soll alles auf eigenen Servern laufen, hilft die Seite zur lokalen KI.
| System | Art | Betrieb laut Doku |
|---|---|---|
| pgvector | Open-Source-Erweiterung für PostgreSQL | In jeder eigenen PostgreSQL-Datenbank |
| Qdrant | Suchplattform für Vektor-, Stichwort- und hybride Suche | Open Source selbst betrieben, Private, Hybrid oder Managed Cloud |
| Milvus | Vektordatenbank unter Apache-2.0-Lizenz | Milvus Lite als Python-Bibliothek, Standalone als Docker-Image, Distributed auf Kubernetes |
| Azure AI Search | Verwalteter Suchdienst von Microsoft | Cloud-Dienst; Vektorsuche laut Microsoft in allen Tarifen ohne Aufpreis, Embeddings können Kosten beim Modellanbieter auslösen |
Checkliste: Vektordatenbank auswählen und testen
Bevor Sie sich festlegen, lohnt ein kleiner Versuch mit echten Dokumenten. Das Beispiel am Ende dieses Abschnitts aus der pgvector-Doku legt eine Tabelle mit dreidimensionalen Vektoren an, sucht die nächsten Nachbarn und erstellt einen HNSW-Index. Echte Embeddings haben je nach Modell Hunderte oder Tausende Dimensionen.
Prüfen Sie danach die Punkte der Liste mit Ihren eigenen Fragen. Möchten Sie die Architektur mit uns durchgehen, können Sie die Wissensdatenbank für Ihr Unternehmen besprechen.
- Bestand: Passt die Lösung zu Datenbanken, die Ihre IT schon betreibt?
- Hybride Suche: Findet sie Artikelnummern und Fachbegriffe ebenso wie Umschreibungen?
- Filter: Lassen sich Rechte, Gültigkeit und Standort als Metadaten filtern?
- Löschen: Verschwinden gelöschte Dokumente samt Vektoren zuverlässig aus dem Index?
- Standort: Wo liegen Daten und Vektoren, und wer betreibt die Server?
CREATE EXTENSION vector;

CREATE TABLE items (id bigserial PRIMARY KEY, embedding vector(3));

INSERT INTO items (embedding) VALUES ('[1,2,3]'), ('[4,5,6]');

SELECT * FROM items ORDER BY embedding <-> '[3,1,2]' LIMIT 5;

CREATE INDEX ON items USING hnsw (embedding vector_cosine_ops);
Häufige Fragen
Was ist der Unterschied zwischen Vektordatenbank und relationaler Datenbank?
Eine relationale Datenbank sucht nach exakten Werten in Spalten, etwa einer Kundennummer. Eine Vektordatenbank sucht nach Ähnlichkeit zwischen Vektoren. Mit Erweiterungen wie pgvector kann eine relationale Datenbank wie PostgreSQL beides.
Was ist semantische Suche?
Semantische Suche findet Inhalte nach ihrer Bedeutung, auch wenn die Wörter abweichen. Technisch übersetzt ein Embedding-Modell Anfrage und Dokumente in Vektoren, und die Suche liefert die Abschnitte mit dem geringsten Abstand zur Anfrage.
Brauche ich für RAG eine eigene Vektordatenbank?
Nicht unbedingt ein eigenes System. pgvector bringt Vektorsuche in eine vorhandene PostgreSQL-Datenbank, und Suchdienste wie Azure AI Search bieten Vektorsuche neben der Stichwortsuche an. Wichtig ist, dass Suche, Filter und Löschung zuverlässig funktionieren.
Was bedeutet HNSW?
HNSW steht für Hierarchical Navigable Small World. Das Verfahren von Malkov und Yashunin baut einen mehrschichtigen Graphen aus den Vektoren und findet damit schnell ungefähre nächste Nachbarn, ohne jeden Vektor einzeln zu vergleichen.
Kann man eine Vektordatenbank selbst betreiben?
Ja. pgvector läuft in jeder eigenen PostgreSQL-Installation, Qdrant gibt es als selbst betriebene Open-Source-Version, und Milvus bietet laut Doku eine Standalone-Variante als Docker-Image. Den Betrieb, die Sicherung und die Updates übernimmt dann Ihre IT.
Quellen
- pgvector: Open-source vector similarity search for Postgres (README), pgvector auf GitHub
- Efficient and robust approximate nearest neighbor search using Hierarchical Navigable Small World graphs (Malkov, Yashunin), arXiv
- Vector Search Overview: Azure AI Search, Microsoft Learn
- Hybrid search (Concepts), Weaviate
- Qdrant Documentation: Overview, Qdrant
- Filtering, Qdrant
- What is Milvus, Milvus
- Generative KI-Modelle: Chancen und Risiken für Industrie und Behörden, Maßnahme M14, BSI
- Embeddings, OpenAI
- Embeddings, Ollama