Kurz gesagt
Lokale KI bezeichnet Sprachmodelle, die auf eigener Hardware statt in der Cloud eines Anbieters laufen. Für eine Wissensdatenbank kombinieren viele Unternehmen Ollama, das Modelle lokal bereitstellt, mit Open WebUI als Oberfläche für Chat, Benutzer und Dokumente. Entscheidend sind genug Grafikspeicher, ein passendes Modell und eine saubere Einrichtung von Zugriffsrechten.
Was ist lokale KI?
Bei lokaler KI läuft das Sprachmodell auf einem Rechner oder Server, den Sie selbst betreiben. Anfragen gehen nicht an einen Cloud-Dienst, sondern an einen Dienst im eigenen Netz. Ollama schreibt dazu in seiner Dokumentation: Bei lokaler Nutzung sieht der Anbieter weder Eingaben noch Daten.
Für den Datenschutz ist das relevant. Die Datenschutzkonferenz (DSK) hält technisch geschlossene Systeme aus datenschutzrechtlicher Sicht für vorzugswürdig. In ihrer Orientierungshilfe zu RAG-Systemen ergänzt sie, dass sich ein solches System unter Umständen on-premise betreiben lässt und personenbezogene Daten dann nicht an Online-Betreiber großer Sprachmodelle übertragen werden.
Lokale KI ist einer von drei Wegen zu einer KI-Wissensdatenbank. Wie sie sich von fertiger Software und einer gebauten Lösung unterscheidet und welche Schritte vor der Technik kommen, zeigt der Leitfaden Wissensdatenbank aufbauen.
Welche Bausteine braucht eine lokale KI-Wissensdatenbank?
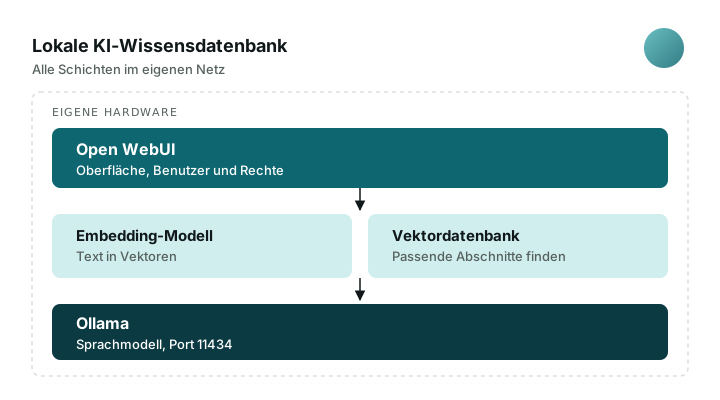
Eine lokale Wissensdatenbank arbeitet nach dem Prinzip Retrieval Augmented Generation: Dokumente werden zerlegt, in Vektoren umgerechnet und bei jeder Frage durchsucht. Die passenden Abschnitte bekommt das Sprachmodell als Grundlage für seine Antwort.
Ollama stellt die Sprachmodelle bereit und bietet eine Programmierschnittstelle, die standardmäßig unter Port 11434 erreichbar ist. Open WebUI liefert die Oberfläche: Chat, Benutzerverwaltung und sogenannte Knowledge Bases, also Dokumentsammlungen für die Suche.
Für die Suche bringt Open WebUI weitere Bausteine mit. Laut Dokumentation unterstützt es unter anderem ChromaDB und PGVector als Vektordatenbank, mehrere Engines zur Textextraktion wie Tika und Docling sowie eine hybride Suche aus Stichwort- und Vektorsuche. Das Embedding-Modell kann lokal in Open WebUI laufen oder über Ollama angebunden werden.
Welche Hardware braucht lokale KI?
Der wichtigste Faktor ist der Grafikspeicher (VRAM). Ollama nennt für sein Einstiegsbeispiel, das Modell gemma4:e2b, einen Download von etwa 7,2 GB und empfiehlt 8 GB verfügbaren VRAM oder entsprechenden gemeinsamen Speicher auf einem Mac. Reicht der VRAM nicht, kann Ollama den Arbeitsspeicher nutzen, die Antworten werden dann aber langsamer.
Planen Sie auch Speicherplatz ein. Laut Ollama können Sprachmodelle Dutzende bis Hunderte Gigabyte groß sein. Unter macOS liegen sie in ~/.ollama/models, unter Linux in /usr/share/ollama/.ollama/models; mit der Variable OLLAMA_MODELS lässt sich der Ort ändern.
Für eine Wissensdatenbank zählt außerdem das Kontextfenster, also wie viel Text das Modell pro Anfrage verarbeitet. Ollama legt es abhängig vom VRAM fest. Open WebUI warnt, dass 4.096 Tokens die Leistung von RAG stark einschränken, weil gefundene Abschnitte dann womöglich nicht oder nur teilweise verarbeitet werden.
| Punkt | Angabe laut Ollama-Dokumentation |
|---|---|
| macOS | Ab macOS Sonoma (v14), Apple M-Serie mit CPU und GPU, x86 nur CPU |
| Windows | Ab Windows 10 22H2, NVIDIA-Treiber ab Version 551.61, mindestens 4 GB für die Installation |
| Linux | Installationsskript, zusätzliche Pakete für AMD-GPUs (ROCm) und ARM64 |
| Kontext unter 24 GiB VRAM | 4k Tokens als Standard |
| Kontext bei 24 bis 48 GiB VRAM | 32k Tokens als Standard |
| Kontext ab 48 GiB VRAM | 256k Tokens als Standard |
Wie installieren Sie Ollama?
Unter macOS und Windows laden Sie die App von ollama.com/download und öffnen sie. Unter Windows läuft Ollama danach im Hintergrund, der Befehl ollama steht in der Eingabeaufforderung und in PowerShell bereit. Unter Linux installieren Sie Ollama mit dem offiziellen Skript.
Danach laden Sie ein Modell und starten einen Test-Chat. Unter Linux starten Sie den Server vorher mit ollama serve, falls er noch nicht läuft. Mit /bye beenden Sie den Chat. Die Befehle stammen wörtlich aus der Dokumentation von Ollama (Stand November 2026).
# Linux: Ollama installieren
curl -fsSL https://ollama.com/install.sh | sh

# Installation prüfen
ollama -v

# Modell laden und Chat starten
ollama pull gemma4:e2b
ollama run gemma4:e2b
Modellnamen ändern sich häufig. Prüfen Sie vor dem Laden auf ollama.com/search, welches Modell zu Ihrem Grafikspeicher und zu deutschsprachigen Dokumenten passt.
Wie installieren Sie Open WebUI?
Open WebUI empfiehlt Docker als offiziell unterstützten Weg. Der folgende Befehl startet Open WebUI und verbindet es mit Ollama auf demselben Rechner. Ersetzen Sie your-secret-key vorher durch die Ausgabe von openssl rand -hex 32. Laut Dokumentation sollten Sie diesen Schlüssel einmal festlegen und behalten, sonst werden bei jedem neu erstellten Container alle Personen abgemeldet.
Danach ist die Oberfläche unter http://localhost:3000 erreichbar. Das Volume open-webui speichert Chats, Benutzer und Einstellungen und bleibt bei Updates erhalten. Für NVIDIA-Grafikkarten gibt es ein eigenes Image mit der Endung :cuda und dem Zusatz --gpus all.
Das erste Konto, das Sie anlegen, ist das Administratorkonto. Danach schaltet sich die Registrierung ab. Weitere Personen lassen Sie über die Einstellung New Sign Ups zu; neue Konten warten dann auf Ihre Freigabe. Ohne Docker geht es auch mit pip install open-webui und open-webui serve; die Dokumentation nennt Python 3.11 und 3.12 als unterstützt.
docker run -d -p 3000:8080 --add-host=host.docker.internal:host-gateway -v open-webui:/app/backend/data -e WEBUI_SECRET_KEY=your-secret-key --name open-webui --restart always ghcr.io/open-webui/open-webui:mainWie binden Sie Dokumente als Wissensdatenbank an?
In Open WebUI heißen Dokumentsammlungen Knowledge. Die Dokumentation beschreibt den Einstieg in wenigen Schritten. Beginnen Sie mit wenigen, gut lesbaren Dokumenten und erweitern Sie erst, wenn die Antworten stimmen.
Wer eine Knowledge Base sehen oder bearbeiten darf, legen Sie über das Drei-Punkte-Menü und den Punkt Access fest. Gruppen und Rollen in Open WebUI helfen, Abteilungen sauber zu trennen. Die DSK nennt ein Rechte- und Rollenkonzept ausdrücklich als Maßnahme für RAG-Systeme.
Erhöhen Sie bei Bedarf das Kontextfenster von Ollama. Die Dokumentation zeigt dafür die Variable OLLAMA_CONTEXT_LENGTH, etwa OLLAMA_CONTEXT_LENGTH=64000 ollama serve. Ein größeres Kontextfenster braucht mehr Grafikspeicher.
Knowledge Base anlegen
Unter Workspace > Knowledge auf Create klicken, Name und Beschreibung vergeben.
Dateien hochladen
Text-PDFs oder Textdateien hochladen und warten, bis die Verarbeitung abgeschlossen ist.
Im Chat verwenden
Die Knowledge Base mit
#im Chat auswählen oder fest einem Modell zuordnen.Antworten prüfen
Eine Frage stellen, deren Antwort im Dokument steht, und Antwort samt Quellenangabe mit dem Original vergleichen.
Was gilt im laufenden Betrieb?
Lokal heißt nicht automatisch offline. Ollama bietet auch Cloud-Modelle an. Wer das ausschließen will, setzt laut Dokumentation OLLAMA_NO_CLOUD=1 oder in ~/.ollama/server.json den Wert disable_ollama_cloud auf true und startet Ollama neu.
Auch Open WebUI baut in der Standardinstallation einzelne Verbindungen nach außen auf, etwa eine Versionsprüfung bei GitHub und eine Update-Prüfung des Embedding-Modells bei Hugging Face. Die Dokumentation beschreibt einen Offline-Modus mit OFFLINE_MODE=true; das Embedding-Modell muss dann vorher heruntergeladen sein.
Ollama bindet sich standardmäßig nur an 127.0.0.1, ist also nur auf dem eigenen Rechner erreichbar. Soll es im Netzwerk erreichbar sein, ändern Sie die Adresse über OLLAMA_HOST. Öffnen Sie diesen Zugang nur hinter einer Firewall oder einem Proxy mit Zugriffskontrolle.
Prüfen Sie die Lizenz. Seit Version 0.6.6 enthält die Lizenz von Open WebUI eine Klausel zum Branding: Name und Logo dürfen nur bei Installationen mit höchstens 50 Personen in 30 Tagen oder mit einer Enterprise-Lizenz entfernt werden. Interne Nutzung mit sichtbarem Branding ist davon nicht eingeschränkt.
Updates sind Ihre Aufgabe. Unter Linux aktualisieren Sie Ollama, indem Sie das Installationsskript erneut ausführen; Open WebUI aktualisieren Sie über ein neues Image. Planen Sie dafür feste Termine ein.
Wann lohnt sich lokale KI für die Wissensdatenbank?
Lokale KI passt, wenn Dokumente das eigene Netz nicht verlassen sollen, wenn ein Team für Betrieb und Updates vorhanden ist und wenn die Fragen mit kleineren Modellen gut beantwortet werden. Die DSK weist darauf hin, dass in RAG-Systemen ein kleines Sprachmodell Vorteile bieten kann, weil das Wissen aus den Dokumenten kommt. Die Eignung des Modells sollte laut DSK immer geprüft und dokumentiert werden.
Weniger passend ist sie, wenn sehr viele Personen gleichzeitig arbeiten oder große Kontextfenster nötig sind, denn beides erhöht den Bedarf an Grafikspeicher. Wie sich eigene Hardware und Abrechnung je Token in der Cloud vergleichen lassen, zeigt die Seite zu den Kosten einer KI-Wissensdatenbank.
Möchten Sie prüfen, ob lokale KI für Ihre Dokumente und Ihr Team passt, können Sie die Wissensdatenbank für Ihr Unternehmen besprechen.
- Daten: Welche Dokumente dürfen das eigene Netz nicht verlassen?
- Team: Wer übernimmt Installation, Updates und Sicherung?
- Last: Wie viele Personen fragen gleichzeitig, und wie lang sind die Dokumente?
- Test: Beantwortet ein lokales Modell Ihre zehn wichtigsten Fragen richtig?
Häufige Fragen
Ist lokale KI DSGVO-konform?
Lokaler Betrieb macht ein System nicht automatisch konform, erleichtert aber vieles. Wer die Anwendung ausschließlich auf eigenen Servern zu eigenen Zwecken betreibt, ist laut DSK in der Regel allein verantwortlich. Eine Rechtsgrundlage, Zugriffsrechte und gegebenenfalls eine Datenschutz-Folgenabschätzung nach Art. 35 DSGVO bleiben nötig.
Was ist Open WebUI?
Open WebUI ist eine selbst gehostete Oberfläche für Sprachmodelle. Sie läuft unter macOS, Linux und Windows, verbindet sich mit Ollama oder Cloud-Anbietern und bietet Benutzerverwaltung sowie Knowledge Bases für die Suche in eigenen Dokumenten.
Läuft Ollama auch ohne Grafikkarte?
Ja, aber langsamer. Unter macOS mit Intel-Prozessor nutzt Ollama laut Dokumentation nur die CPU. Reicht der Grafikspeicher nicht, weicht Ollama auf den Arbeitsspeicher aus, die Antworten dauern dann länger.
Sendet Ollama meine Daten an ollama.com?
Bei lokal laufenden Modellen nicht. Laut Ollama sieht der Anbieter dabei weder Eingaben noch Daten. Bei Cloud-Modellen verarbeitet Ollama Eingaben und Antworten, speichert sie laut eigener Angabe aber nicht und nutzt sie nicht zum Training. Die Cloud-Funktionen lassen sich mit OLLAMA_NO_CLOUD=1 abschalten.
Können mehrere Mitarbeitende die lokale KI nutzen?
Ja. Open WebUI verwaltet mehrere Konten mit Rollen und Gruppen. Das erste Konto ist das Administratorkonto, weitere Konten gibt die Administration nach der Registrierung frei. Damit Ollama im Netzwerk erreichbar ist, muss die Adresse über OLLAMA_HOST angepasst werden.
Quellen
- Linux: Install, Ollama
- Quickstart, Ollama
- macOS und Windows: System Requirements, Ollama
- FAQ und Context length, Ollama
- Quick Start, Open WebUI
- Knowledge Bases and Document Chat, Open WebUI
- Run Open WebUI Offline, Open WebUI
- Open WebUI License, Open WebUI
- Orientierungshilfe zu datenschutzrechtlichen Besonderheiten generativer KI-Systeme mit RAG-Methode (Oktober 2025), Datenschutzkonferenz (DSK)
- Orientierungshilfe Künstliche Intelligenz und Datenschutz (Mai 2024), Datenschutzkonferenz (DSK)