Kurz gesagt
Die Kosten einer KI-Wissensdatenbank setzen sich aus einmaligen Posten wie Aufbereitung der Dokumente, Einrichtung und gegebenenfalls Hardware sowie laufenden Posten wie Modellnutzung, Speicher, Betrieb und Pflege zusammen. In der Cloud zahlen Sie je verarbeitetem Token, bei eigener Hardware vor allem für Anschaffung und Betrieb. Den größten Hebel haben Dokumentenmenge, Anfragen und Modellwahl.
Wovon hängen die Kosten einer KI-Wissensdatenbank ab?
Die Kosten einer KI-Wissensdatenbank entstehen an mehreren Stellen. Technisch arbeiten die meisten Systeme nach dem Prinzip Retrieval Augmented Generation: Dokumente werden zerlegt, in Vektoren umgerechnet und gespeichert; bei jeder Frage sucht das System passende Abschnitte und gibt sie einem Sprachmodell mit. Jeder dieser Schritte verursacht Aufwand oder Gebühren.
Sechs Faktoren bestimmen die Summe. Sie gelten für jede Betriebsform, ob fertige Software, eigene Hardware oder eine gebaute Lösung. Welcher Weg zu Ihnen passt, erklärt der Leitfaden Wissensdatenbank aufbauen.
- Dokumente: Menge, Format und Zustand bestimmen den Aufwand für die Aufbereitung.
- Anfragen: Zahl der Personen und Fragen pro Tag treiben die laufenden Kosten.
- Modell: Große Modelle kosten je Token ein Vielfaches kleiner Modelle.
- Kontext: Je mehr Text pro Frage mitgeht, desto mehr Tokens werden berechnet.
- Betrieb: Cloud-Dienst oder eigene Hardware mit eigenem Personal.
- Pflege: Aktualisieren, Löschen und Neuindizieren laufen dauerhaft weiter.
Welche Kosten fallen einmalig an, welche laufend?
Trennen Sie bei der Planung einmalige von laufenden Kosten. Viele Schätzungen betrachten nur die Modellgebühren und übersehen, dass Aufbereitung und Pflege der Dokumente meist mehr Arbeitszeit binden als die Technik.
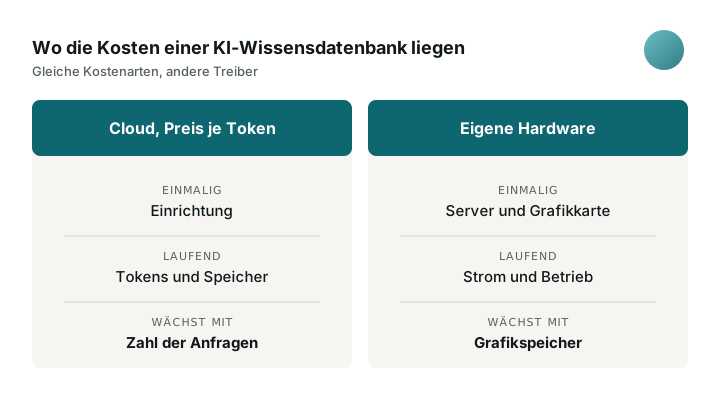
Die Tabelle ordnet typische Posten. Welche davon bei Ihnen anfallen, hängt von der Betriebsform ab: Bei fertiger Software entfällt die Hardware, bei eigener Hardware entfallen die Gebühren je Token.
| Kostenart | Einmalig | Laufend |
|---|---|---|
| Dokumente | Sichten, bereinigen, Texterkennung bei Scans | Neue Fassungen einpflegen, Veraltetes löschen |
| Embeddings | Erstes Umrechnen aller Dokumente in Vektoren | Neue Dokumente, Neuindizierung bei Modellwechsel |
| Sprachmodell | Bei eigener Hardware: Server und Grafikkarte | In der Cloud: Gebühren je Token |
| Speicher | Bei eigener Hardware: Plattenplatz für Modelle | In der Cloud: Speichergebühren je GB |
| Einrichtung | Installation, Anbindung, Rechte, Tests | Updates, Überwachung, Sicherung |
| Recht und Organisation | Verträge, Datenschutz-Folgenabschätzung, Regeln | Überprüfung bei Änderungen, Schulung neuer Personen |
Wie rechnen Cloud-Modelle ab?
Cloud-Anbieter berechnen Sprachmodelle nach Tokens, also kleinen Textbausteinen. Eingabe und Ausgabe haben getrennte Preise, die Ausgabe ist in der Regel teurer. Bei einer Wissensdatenbank zählen zur Eingabe die Frage und jeder gefundene Textabschnitt, der mitgeschickt wird.
Die folgenden Preise stammen aus den offiziellen Preisseiten, Stand laut Anbieter, November 2026. Alle Angaben in US-Dollar je eine Million Tokens, Standardabrechnung ohne Rabatte. Die Auswahl zeigt die Spanne und ist kein Vergleich der Qualität.
Hinzu kommen Aufschläge und Rabatte. OpenAI berechnet für Endpunkte mit regionaler Datenverarbeitung bei Modellen ab dem 5. März 2026 einen Aufschlag von 10 Prozent; Anthropic nennt für die Verarbeitung ausschließlich in den USA den Faktor 1,1. Wer Anfragen nicht sofort braucht, zahlt bei der Batch-Verarbeitung weniger: OpenAI listet für Batch etwa die Hälfte des Standardpreises, Google nennt 50 Prozent Ersparnis.
Achten Sie auf die Bedingungen kostenloser Stufen. Google schreibt auf seiner Preisseite, dass Inhalte aus der kostenlosen Stufe der Gemini API zur Verbesserung der Produkte verwendet werden, in der bezahlten Stufe nicht. Für Firmendokumente ist das ein Grund, nicht mit Gratiszugängen zu arbeiten.
| Anbieter und Modell | Eingabe | Ausgabe |
|---|---|---|
| OpenAI gpt-6-astra | 10,00 $ | 50,00 $ |
| OpenAI gpt-6.1-terra | 1,00 $ | 5,00 $ |
| OpenAI gpt-6-luna | 0,10 $ | 0,50 $ |
| Anthropic Claude Opus 5.5 | 4,00 $ | 20,00 $ |
| Anthropic Claude Sonnet 5.5 | 2,00 $ | 10,00 $ |
| Anthropic Claude Haiku 5.5 (Prompts bis 100.000 Tokens) | 0,10 $ | 0,50 $ |
| OpenAI text-embedding-3-small (Embeddings) | 0,02 $ | entfällt |
| OpenAI text-embedding-3-large (Embeddings) | 0,13 $ | entfällt |
Preise ändern sich häufig. Prüfen Sie vor jeder Kalkulation die aktuelle Preisseite des Anbieters. Alle Preise: Stand laut Anbieter, November 2026, ohne Umsatzsteuer und Währungsumrechnung.
Cloud oder eigene Hardware: Was rechnet sich?
In der Cloud wachsen die Kosten mit der Nutzung. Wenige Anfragen kosten wenig, viele Anfragen mit langen Textabschnitten summieren sich. Dazu kommen Gebühren für Zusatzdienste: OpenAI berechnet für die eingebaute Dateisuche 0,10 $ je GB und Tag Speicher, wobei 1 GB frei ist, und 2,50 $ je 1.000 Aufrufe (Stand laut Anbieter, November 2026).
Bei lokaler KI auf eigener Hardware fallen keine Gebühren je Token an. Die Kosten stecken in Anschaffung, Strom und Betrieb. Den Bedarf bestimmt vor allem der Grafikspeicher: Ollama empfiehlt für sein Einstiegsmodell 8 GB VRAM und legt das Kontextfenster abhängig vom VRAM fest, unter 24 GiB auf 4k Tokens. Modelle belegen laut Ollama Dutzende bis Hunderte Gigabyte Plattenplatz.
Prüfen Sie bei Open Source auch die Lizenz. Open WebUI ist kostenlos nutzbar, verlangt aber seit Version 0.6.6 sichtbares Branding, sobald eine Installation mehr als 50 Personen in 30 Tagen bedient, außer Sie erwerben eine Enterprise-Lizenz.
Eine pauschale Schwelle, ab der eigene Hardware günstiger ist, gibt es nicht. Stellen Sie die erwarteten Anfragen pro Monat den Kosten für Hardware und Personal gegenüber und rechnen Sie beide Seiten über denselben Zeitraum.
Wie schätzen Sie die laufenden Modellkosten?
Mit vier Zahlen schätzen Sie die Modellkosten in der Cloud selbst. Das folgende Beispiel ist eine reine Rechenübung mit angenommenen Werten, keine Aussage über ein echtes Projekt.
Annahme: 1.000 Fragen im Monat, je Frage 4.000 Tokens Eingabe einschließlich der gefundenen Textabschnitte und 500 Tokens Ausgabe. Mit Claude Sonnet 5.5 ergibt das 4 Millionen Eingabe-Tokens zu 2,00 $ und 0,5 Millionen Ausgabe-Tokens zu 10,00 $, zusammen 13,00 $. Mit OpenAI gpt-6-luna sind es bei denselben Mengen 0,65 $.
Das einmalige Umrechnen der Dokumente fällt meist kaum ins Gewicht: 10 Millionen Tokens kosten mit text-embedding-3-small 0,20 $. Teurer als die Gebühren ist oft die Arbeitszeit für Aufbereitung, Tests und Pflege.
Anfragen schätzen
Zahl der Personen mal Fragen pro Tag mal Arbeitstage im Monat.
Tokens je Anfrage bestimmen
Frage plus mitgeschickte Textabschnitte als Eingabe, dazu die übliche Länge der Antwort.
Preise einsetzen
Eingabe- und Ausgabe-Tokens getrennt mit den Preisen je Million Tokens multiplizieren.
Zuschläge prüfen
Regionale Verarbeitung, Speicher, Dateisuche und Embeddings für neue Dokumente addieren.
Welche Kosten werden oft übersehen?
Neuindizierung: Wer das Embedding-Modell wechselt, muss alle Dokumente neu umrechnen. Die Dokumentation von Open WebUI begründet das damit, dass Vektoren verschiedener Modelle nicht zueinander passen. Bei großen Beständen kostet das Rechenzeit oder Gebühren. Mehr zu den Grundlagen erklärt die Seite zu Embeddings.
Datenschutz: Enthalten die Dokumente personenbezogene Daten, kann eine Datenschutz-Folgenabschätzung nach Art. 35 DSGVO nötig werden. Die Datenschutzkonferenz (DSK) schreibt, dass dies beim Einsatz von KI-Anwendungen vielfach der Fall sein wird. Nutzen Sie einen Cloud-Dienst, kommt ein Vertrag zur Auftragsverarbeitung nach Art. 28 DSGVO hinzu.
Pflege: Laut DSK muss die verantwortliche Stelle regelmäßig prüfen, ob die Dokumente aktuell und vollständig sind. Planen Sie dafür feste Stunden je Fachbereich ein, auch nach dem Start.
Kontext: Lange Textabschnitte verbessern manche Antworten, erhöhen aber die Eingabe-Tokens bei jeder Frage. Wie Sie Abschnitte sinnvoll schneiden, zeigt die Seite zum Chunking.
Checkliste: So halten Sie die Kosten im Rahmen
Die folgenden Punkte senken die Kosten, ohne die Qualität der Antworten aufs Spiel zu setzen. Sie lassen sich bei fertiger Software, eigener Hardware und gebauten Lösungen anwenden. Wie eine KI-Wissensdatenbank im Alltag arbeitet, zeigt die Startseite.
Möchten Sie die Kosten für Ihren Dokumentenbestand und Ihre Nutzung einschätzen lassen, können Sie die Wissensdatenbank für Ihr Unternehmen besprechen.
- Klein starten: mit einer Abteilung beginnen und echte Nutzungszahlen messen.
- Modell passend wählen: zuerst ein kleines Modell mit den eigenen Testfragen prüfen.
- Bestand ausdünnen: Dubletten und veraltete Fassungen vor dem Import löschen.
- Kontext begrenzen: nur so viele Abschnitte mitschicken, wie die Antwort braucht.
- Batch nutzen: Aufgaben ohne Zeitdruck über günstigere Batch-Schnittstellen laufen lassen.
- Preise beobachten: Preisseiten bei jeder Vertragsverlängerung neu prüfen.
Häufige Fragen
Was kostet eine KI-Wissensdatenbank im Monat?
Eine seriöse Pauschale gibt es nicht. In der Cloud hängen die laufenden Kosten von Zahl der Anfragen, Tokens je Anfrage und Modellpreis ab; bei eigener Hardware von Strom, Wartung und Personal. Mit dem Rechenweg auf dieser Seite schätzen Sie die Modellkosten aus Ihren eigenen Zahlen.
Was ist ein Token?
Ein Token ist ein Textbaustein, in den Sprachmodelle Texte zerlegen, etwa ein Wort oder ein Wortteil. Cloud-Anbieter berechnen Eingabe und Ausgabe getrennt je eine Million Tokens.
Ist eine lokale KI günstiger als die Cloud?
Das hängt von der Nutzung ab. Lokal fallen keine Gebühren je Token an, dafür Kosten für Hardware, Strom und Betrieb. Bei wenigen Anfragen bleiben die Gebühren je Token gering, bei dauerhaft hoher Nutzung wachsen sie mit jeder Frage. Rechnen Sie beide Seiten über denselben Zeitraum.
Was kosten Embeddings?
Bei OpenAI kostet text-embedding-3-small 0,02 $ und text-embedding-3-large 0,13 $ je eine Million Tokens, Stand laut Anbieter, November 2026. Lokal laufen Embedding-Modelle ohne Gebühr, etwa in Open WebUI oder über Ollama.
Kann ich die kostenlose Stufe einer KI-API für Firmendaten nutzen?
Prüfen Sie die Bedingungen genau. Google schreibt auf seiner Preisseite, dass Inhalte aus der kostenlosen Stufe der Gemini API zur Verbesserung der Produkte verwendet werden. Die DSK hält Anwendungen für vorzugswürdig, die Ein- und Ausgaben nicht zum Training verwenden.
Quellen
- Pricing (Stand laut Anbieter, November 2026), OpenAI
- Pricing (Stand laut Anbieter, November 2026), Anthropic
- Gemini Developer API pricing (Stand laut Anbieter, November 2026), Google
- Context length, Ollama
- Quickstart: Run a model locally, Ollama
- macOS: Filesystem Requirements, Ollama
- Open WebUI License, Open WebUI
- Retrieval Augmented Generation (RAG): Changing the Embedding Model, Open WebUI
- Orientierungshilfe zu datenschutzrechtlichen Besonderheiten generativer KI-Systeme mit RAG-Methode (Oktober 2025), Datenschutzkonferenz (DSK)
- Orientierungshilfe Künstliche Intelligenz und Datenschutz (Mai 2024), Datenschutzkonferenz (DSK)