Kurz gesagt
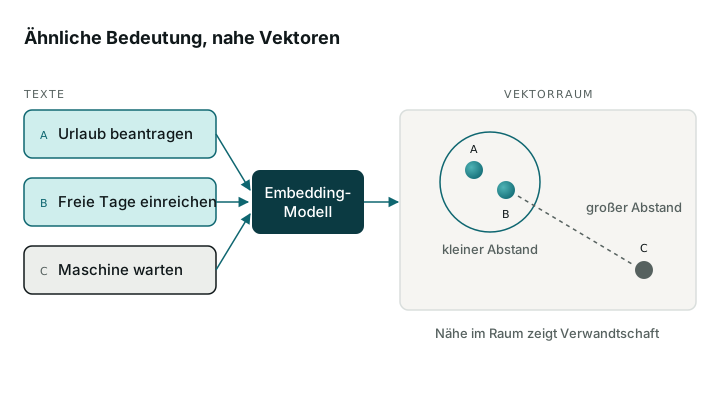
Embeddings sind Vektoren, also Listen von Kommazahlen, die ein KI-Modell aus Texten, Bildern oder anderen Daten berechnet. Inhalte mit ähnlicher Bedeutung liegen dabei nah beieinander, und der Abstand zweier Vektoren zeigt, wie verwandt sie sind. Embeddings sind die Grundlage für semantische Suche, Vektordatenbanken und RAG-Systeme mit Firmenwissen.
Was sind Embeddings?
Ein Embedding ist laut OpenAI ein Vektor, also eine Liste von Gleitkommazahlen. Der Abstand zwischen zwei solchen Vektoren misst, wie verwandt die zugrunde liegenden Inhalte sind: Ein kleiner Abstand bedeutet hohe Verwandtschaft, ein großer Abstand geringe. Das englische Wort heißt so viel wie „Einbettung“, denn jeder Text wird an eine Stelle in einem Raum mit vielen Dimensionen eingebettet.
Wie viele Zahlen ein Embedding hat, legt das Modell fest. Ollama nennt typische Längen von 384 bis 1.024 Dimensionen, die Modelle text-embedding-3-small und text-embedding-3-large von OpenAI liefern standardmäßig 1.536 und 3.072 Dimensionen.
OpenAI nennt als Einsatzzwecke Suche, Clustering, Empfehlungen, die Erkennung von Ausreißern, die Messung von Vielfalt und Klassifikation. Für eine KI-Wissensdatenbank zählt vor allem der erste Punkt: Embeddings machen es möglich, Firmendokumente nach Bedeutung zu durchsuchen.
Wie entstehen Embeddings?
Embeddings entstehen in einem neuronalen Netz, das auf großen Textmengen trainiert wurde. Bekannt wurde die Idee durch word2vec von Mikolov und Kollegen (2013): Die Autoren lernten Vektoren für einzelne Wörter aus einem Datensatz mit 1,6 Milliarden Wörtern in weniger als einem Tag und erreichten damit gute Ergebnisse bei der Messung syntaktischer und semantischer Ähnlichkeit von Wörtern.
Für die Suche in Dokumenten braucht man Vektoren für ganze Sätze und Absätze. Reimers und Gurevych zeigten 2019 mit Sentence-BERT den Unterschied: Um in 10.000 Sätzen das ähnlichste Paar zu finden, braucht das Sprachmodell BERT etwa 50 Millionen Berechnungen, rund 65 Stunden. Mit Satz-Embeddings, die sich per Kosinus-Ähnlichkeit vergleichen lassen, dauert dieselbe Aufgabe etwa 5 Sekunden.
Der Grund: Jeder Satz wird nur einmal in einen Vektor übersetzt und danach nur noch verglichen. Genau dieses Prinzip nutzt jede Vektordatenbank für die semantische Suche. Die Dokumente werden einmal beim Indexieren vektorisiert, jede Frage bei der Suche.
Wie misst man die Ähnlichkeit von Embeddings?
Das gängige Maß ist die Kosinus-Ähnlichkeit. Sie betrachtet den Winkel zwischen zwei Vektoren: Zeigen beide in dieselbe Richtung, sind die Inhalte ähnlich. OpenAI empfiehlt sie für seine Modelle und weist darauf hin, dass die Vektoren auf die Länge 1 normiert sind. Dann liefert schon das einfache Skalarprodukt dasselbe Ergebnis, und die Rangfolge entspricht der des euklidischen Abstands.
Auch der Embedding-Endpunkt von Ollama gibt laut Doku normierte Vektoren zurück und nennt die Kosinus-Ähnlichkeit als Empfehlung für die meisten Fälle semantischer Suche. Welche Abstandsmaße eine Datenbank anbietet, steht auf der Seite zur Vektordatenbank.
Eine Regel gilt immer: Dokumente und Fragen müssen mit demselben Modell vektorisiert werden. Ollama nennt das ausdrücklich. Vektoren aus zwei verschiedenen Modellen liegen in verschiedenen Räumen und lassen sich nicht sinnvoll vergleichen. Wer das Modell wechselt, muss den gesamten Bestand neu vektorisieren.
Welches Embedding-Modell passt für deutsche Dokumente?
Eine allgemeine Bestenliste hilft nur begrenzt. Der Benchmark MTEB von Muennighoff und Kollegen umfasst in seiner ersten Fassung 8 Aufgabenarten, 58 Datensätze und 112 Sprachen, und die Autoren schreiben, dass keine Methode bei allen Aufgaben vorne liegt. Für Ihre Dokumente zählt, wie ein Modell auf deutschen Fachtexten und Ihren typischen Fragen abschneidet.
Achten Sie neben der Sprache auf die maximale Eingabelänge und die Zahl der Dimensionen. Mehr Dimensionen brauchen mehr Speicher im Index. OpenAI erlaubt deshalb, Embeddings über den Parameter dimensions zu kürzen, und schreibt, dass ein auf 256 Dimensionen gekürztes Embedding von text-embedding-3-large im MTEB noch besser abschneidet als das ältere Modell text-embedding-ada-002 mit 1.536 Dimensionen.
Die Tabelle nennt Beispiele mit Angaben aus Doku und Papers, Stand laut Anbieter, November 2026. Sie ist keine Rangliste.
| Modell | Betrieb | Angaben laut Quelle |
|---|---|---|
| text-embedding-3-small (OpenAI) | Cloud-API | 1.536 Dimensionen, bis 8.192 Token Eingabe |
| text-embedding-3-large (OpenAI) | Cloud-API | 3.072 Dimensionen, kürzbar, bis 8.192 Token Eingabe |
| Multilingual E5 (small, base, large) | Open Source, selbst betreibbar | Mehrsprachig, drei Größen zwischen Geschwindigkeit und Qualität |
| BGE-M3 | MIT-Lizenz, selbst betreibbar | Über 100 Sprachen, Dense, Sparse und Multi-Vector, bis 8.192 Token |
| embeddinggemma über Ollama | Lokal über Ollama | Beispielmodell der Ollama-Doku, normierte Vektoren |
Welche Rolle spielen Embeddings in RAG?
In einem RAG-System entscheiden Embeddings, welche Abschnitte das Sprachmodell überhaupt zu sehen bekommt. Ein Modell, das deutsche Fachbegriffe schlecht abbildet, liefert unpassende Treffer, und das Sprachmodell antwortet dann auf falscher Grundlage. Ein späteres Reranking kann nur unter den Treffern sortieren, die die Suche gefunden hat.
Was ein Embedding abbildet, hängt auch vom Zuschnitt des Textes ab. Ein Abschnitt, der mitten in einer Tabelle beginnt, ergibt einen Vektor ohne klaren Sinn. Wie Sie Dokumente sinnvoll zerlegen, steht auf der Seite zum Chunking.
Anthropic hat gezeigt, wie viel der Zuschnitt ausmacht: Erhält jeder Abschnitt vor dem Vektorisieren einen kurzen erklärenden Kontext aus dem Gesamtdokument, sank in den Tests des Unternehmens der Anteil fehlgeschlagener Suchen unter den Top 20 Treffern um 35 Prozent. Das ist ein Messwert des Anbieters auf seinen Testdaten.
Cloud oder eigene Hardware: Datenschutz bei Embeddings
Um ein Embedding zu berechnen, muss das Modell den Text lesen. Bei einer Cloud-API gehen alle Dokumentabschnitte und alle Fragen an den Anbieter. Enthalten sie personenbezogene Daten, gelten die Regeln der DSGVO für diese Übermittlung; welche Fragen das bei einzelnen KI-Diensten aufwirft, erklärt die Seite zum KI-Datenschutz auf kiagentensicherheit.de.
Embedding-Modelle lassen sich auch selbst betreiben. Ollama stellt dafür einen Endpunkt auf dem eigenen Rechner bereit, Multilingual E5 ist laut technischem Bericht Open Source, und BGE-M3 steht auf Hugging Face unter MIT-Lizenz zum Download. Wie ein solcher Betrieb auf eigener Hardware aussieht, zeigt die Seite zur lokalen KI.
Denken Sie auch an die Löschung. Verlangt eine Person nach Art. 17 DSGVO die Löschung ihrer Daten, betrifft das neben dem Originaldokument auch die gespeicherten Abschnitte und Vektoren im Index.
So testen Sie Embedding-Modelle mit eigenen Daten
Ein Test mit eigenen Dokumenten sagt mehr als jeder Benchmark. Das folgende Beispiel aus der Ollama-Doku berechnet ein Embedding auf dem eigenen Rechner; im Feld input darf auch eine Liste mehrerer Texte stehen.
Wollen Sie die Modellwahl mit Ihren Dokumenten durchspielen, können Sie die Wissensdatenbank für Ihr Unternehmen besprechen.
Testsatz anlegen
Sammeln Sie 30 bis 50 echte Fragen und notieren Sie zu jeder den Abschnitt, der die Antwort enthält.
Kandidaten wählen
Nehmen Sie zwei bis drei Modelle mit deutscher oder mehrsprachiger Unterstützung in die engere Wahl.
Bestand vektorisieren
Vektorisieren Sie dieselben Abschnitte mit jedem Modell in einen eigenen Index.
Treffer vergleichen
Prüfen Sie je Modell, wie oft der richtige Abschnitt unter den ersten fünf Treffern steht.
Betrieb abwägen
Wägen Sie Trefferqualität gegen Speicherbedarf, Kosten und den Ort der Verarbeitung ab.
curl -X POST http://localhost:11434/api/embed \
  -H "Content-Type: application/json" \
  -d '{
    "model": "embeddinggemma",
    "input": "The quick brown fox jumps over the lazy dog."
  }'
Häufige Fragen
Was ist ein Embedding einfach erklärt?
Ein Embedding ist eine Art Koordinate für Bedeutung. Ein KI-Modell übersetzt einen Text in eine lange Liste von Zahlen, und Texte mit ähnlichem Inhalt bekommen ähnliche Zahlen. So kann ein Computer Bedeutungen vergleichen.
Was ist der Unterschied zwischen Embedding und Token?
Ein Token ist ein Textbaustein, etwa ein Wort oder Wortteil, in den ein Modell Text zerlegt. Ein Embedding ist der Zahlenvektor, den ein Modell für einen Text berechnet. Die maximale Eingabelänge eines Embedding-Modells wird in Token angegeben, bei den aktuellen OpenAI-Modellen 8.192.
Kann ich Embeddings verschiedener Modelle mischen?
Nein. Vektoren verschiedener Modelle liegen in verschiedenen Räumen. Dokumente und Fragen müssen mit demselben Modell vektorisiert werden, und ein Modellwechsel bedeutet, den ganzen Bestand neu zu berechnen.
Wie viele Dimensionen braucht ein Embedding?
Das legt das Modell fest, eine allgemeingültige Zahl gibt es nicht. Ollama nennt typische Werte von 384 bis 1.024, OpenAI-Modelle liefern 1.536 oder 3.072 Dimensionen und lassen sich kürzen. Mehr Dimensionen brauchen mehr Speicher; ob sie bessere Treffer liefern, zeigt nur ein Test mit Ihren Daten.
Quellen
- Embeddings (Vector embeddings guide), OpenAI
- Embeddings, Ollama
- Efficient Estimation of Word Representations in Vector Space (Mikolov et al., 2013), arXiv
- Sentence-BERT: Sentence Embeddings using Siamese BERT-Networks (Reimers, Gurevych, EMNLP 2019), arXiv
- MTEB: Massive Text Embedding Benchmark (Muennighoff et al., 2022), arXiv
- Multilingual E5 Text Embeddings: A Technical Report (Wang et al., 2024), arXiv
- M3-Embedding: Multi-Linguality, Multi-Functionality, Multi-Granularity Text Embeddings (Chen et al., 2024), arXiv
- Introducing Contextual Retrieval, Anthropic
- BAAI/bge-m3 (Modellseite), Hugging Face
- Art. 17 DSGVO: Recht auf Löschung, dsgvo-gesetz.de